
AI-агенты в пентесте и bug bounty
Заполни форму, и видео запустится здесь же.
Готово. Видео появится здесь, как только загрузим его.
Нажимая кнопку, соглашаешься с обработкой персональных данных
О чём эфир
Здесь AI в пентесте и багбаунти как он есть, без мифов про полную автономию. Поймёшь, где агенты экономят часы, а где галлюцинируют.
Почему AI пока плохо пишет отчёты и почему гибрид из AI и своих скриптов работает надёжнее, чем одна модель. Агент читает файлы проекта и находит уязвимости, а рядом сравнение с ручным тестом.
Ещё тест пяти AI-инструментов, MCP или свои скиллы, локальные модели против облачных, работа с аутентификацией и юридические риски выхода за scope.

Забери материалы эфира
Презентацию одним файлом: вернись к ним, когда будешь повторять на практике.
Скачать материалыРазбор эфира по темам
AI в пентесте: усиливает, но не заменяет
Вокруг AI в наступательной безопасности (offensive security) много громких историй: про автономных ботов, которые сами занимают первые места в рейтингах багбаунти и находят уязвимости пачками. На практике пентест (тестирование на проникновение) с нейросетями выглядит скромнее.
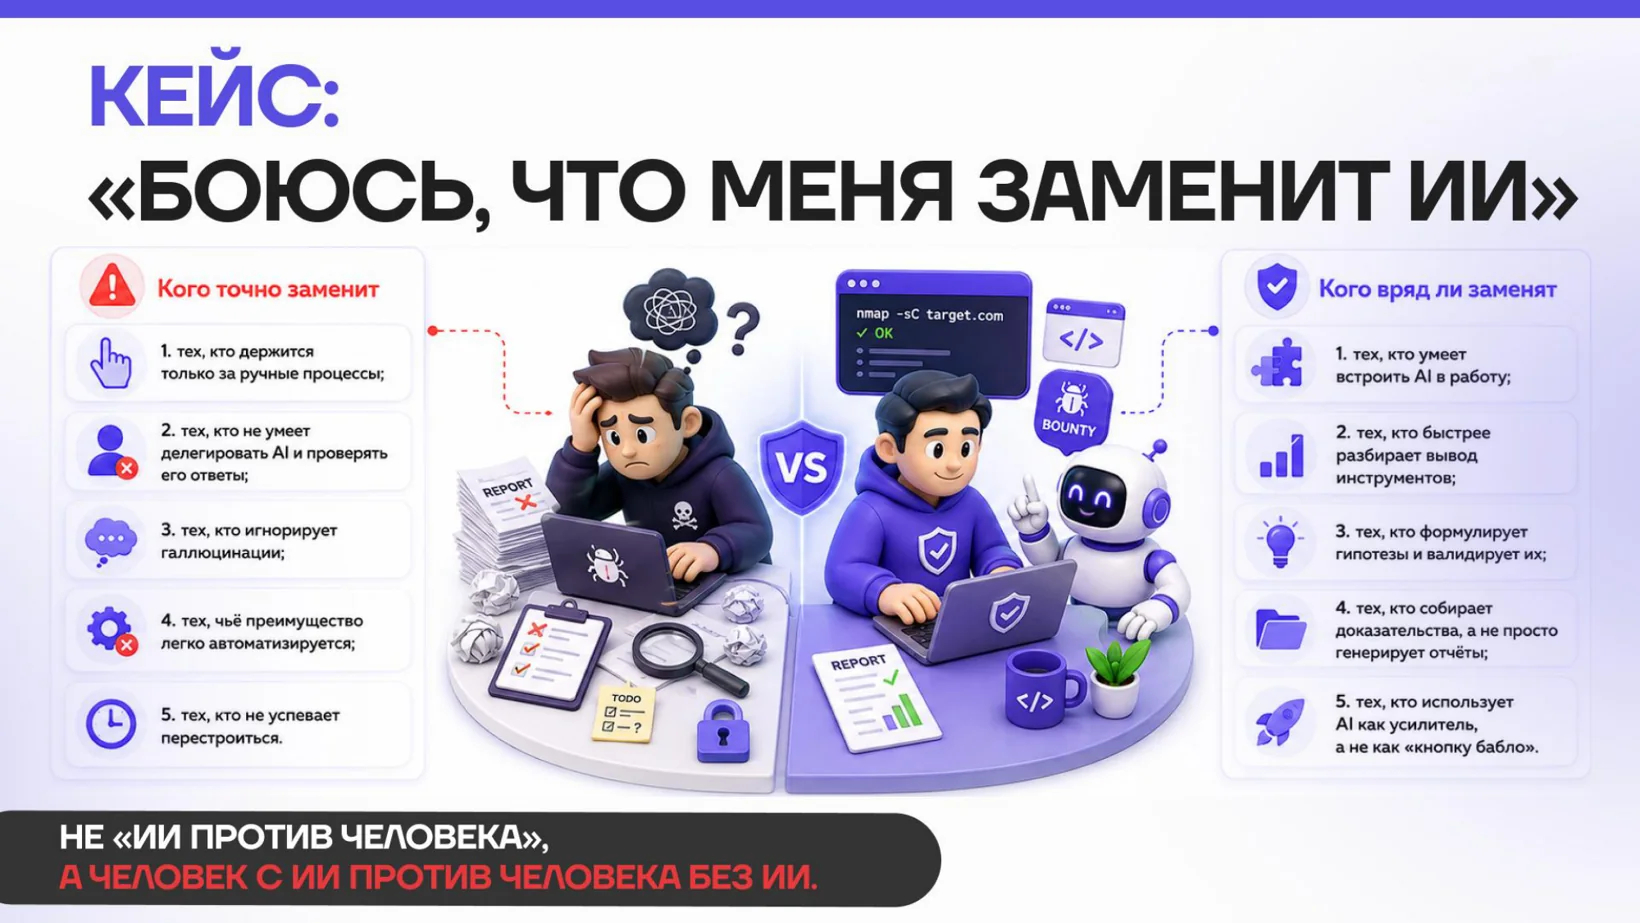
Автономного AI-пентестера пока нет: агента приходится постоянно допиливать, дообучать под задачу и следить за его состоянием.
Полностью заменить AI не может тех, чья работа требует физического присутствия: выход на территорию заказчика, физическая социальная инженерия, часть задач red team. Трудно заменить и тех, кто способен придумывать новое, потому что модель умеет синтезировать то, на чём обучалась, но не создавать уникальное. Остальным стоит научиться работать с нейросетями раньше, чем это сделают коллеги.
Заменит не AI человека. Человек, использующий нейросети, заменит того, кто их не использует.
Сергей ЗыбневВ карьере пентестера это уже даёт эффект. Путь, который встречается чаще всего, выглядит так. Сильный пентестер перерастает свои задачи, уходит в более серьёзную команду, берётся там за внутренние исследования и в итоге переходит на R&D (исследования и разработку), где платят заметно больше. R&D-команд в России мало, они стоят дорого, и специалисты в них ценятся высоко.
Почему отчёты от AI пока засоряют bug bounty
Главная боль платформ багбаунти последние полгода это поток отчётов, написанных моделью. По форме они бывают гладкими, но низкого качества и редко совпадают с тем, что есть на самом деле. Был случай, когда вместо отчёта человек прислал платформе ссылку на публичный чат с моделью со словами «спроси у неё, что она нашла». Такие отчёты бьют по триажерам, тем самым людям, которые помогают исследователю получить выплату.
Для коммерческого пентеста писать отчёт целиком или почти целиком моделью не стоит. Заказчику важно из проекта в проект получать стабильный результат с одними и теми же формулировками, а модель каждый раз формулирует чуть иначе.
Систему генерации отчётов по пентесту лучше строить на управляемом коде с шаблоном, а не на свободной генерации.
А вот классификация и приоритизация находок автоматизируется хорошо. Разбор отчётов по критичности на основе названия и описания уязвимости надёжнее делать через машинное обучение, а не через языковую модель. Это и точнее под узкую задачу, и в разы дешевле, потому что инференс большой модели стоит дорого. Модель полезна на другом шаге: ей можно скормить находки сканера и попросить перепроверить, где настоящая уязвимость, а где ложное срабатывание.
Автоматизация пентеста: где агент экономит часы, а где галлюцинирует
Рутина это то, где выигрыш от автоматизации очевиден. Разведка хорошо автоматизируется обычными скриптами на bash и Python: сканер портов отдаёт данные дальше по конвейеру в следующий инструмент, и так собирается привычный пайплайн. Гайдов по такой автоматизации много, и работает она в основном на этапе сбора информации.
На активной эксплуатации всё сложнее. Логику авторизации у маркетплейса и у банковского приложения не описать одним набором паттернов, это разные миры. Здесь модель помогает иначе: она смотрит, как приложение реагирует, и помогает подгонять твои же скрипты под конкретный случай.
Важно понимать природу модели. Она недетерминирована и каждый раз генерирует чуть разный ответ. В локальных моделях это регулируется температурой: ноль делает ответы однообразными, единица более творческими.
Полностью убрать галлюцинации нейросети технически нельзя, поэтому надёжная часть работы всё равно держится на скриптах.
Мы привыкли называть галлюцинацией тот ответ, который нам не нравится. А тот, который нас устраивает, не называем. Хотя галлюцинация и то, и другое.
Сергей ЗыбневЮридические риски AI-агента важнее любой находки
Законодательства, которое снимало бы с оператора модели ответственность за действия AI-агента, пока нет ни в России, ни в мире. Любая выполненная агентом деструктивная команда, случайно задетый баннер заказчика или удалённая таблица это ответственность человека, который запустил агента. Есть уголовные статьи о неправомерном доступе, и отвечать по ним будет оператор. Отсюда простое правило работы.
Нужно сидеть за монитором и внимательно смотреть, что делает агент: если он начинает ломать твою же систему или выполнять деструктивные действия, его сразу останавливают.
Отдельно важно соблюдать scope, границы разрешённого тестирования. Подписанное пользовательское соглашение действует, даже если ты работаешь со своего личного аккаунта, и выход за границы программы вполне может закончиться разговором с юристами.
Хуки в AI-агентах как ремень безопасности
Снизить риск помогает механизм хуков, который есть в большинстве консольных AI-агентов. Хук механически блокирует опасное действие до того, как оно выполнится, и возвращает модели ответ, что так делать нельзя.
- запрет на rm -rf с любыми путями, не только от root; безопасный вариант при этом может сам выполнить нужную операцию за агента;
- защита от LOLBin-атак, когда систему пытаются атаковать встроенными утилитами;
- принудительный выбор инструмента, например запуск только через нужный пакетный менеджер.
Все защиты предусмотреть нельзя, поэтому хуки не отменяют внимания человека, а дополняют его.
Как AI-агент находит уязвимости: метод гипотез
В работе сильный агент идёт не перебором всех типов уязвимостей подряд, а гипотезами.
- 1
Разбирается, что ему дали в scope и как устроен функционал.
- 2
Строит в голове модель приложения.
- 3
Выдвигает гипотезу и проверяет её.
- 4
Прогоняет каждое действие через верификационный цикл, чтобы не остановиться на первой же находке, а докрутить её, если того требует задача.
Тяжёлые инструменты ему при этом часто не нужны. В разборе одной лабы агент не трогал перебор каталогов и шумные сканеры, а обошёлся переменными окружения и обычными запросами curl. Он сам сформировал CSRF-токен, авторизовался по выданному логину и паролю, нашёл загрузку файла в личном кабинете и через схемы вроде file, http, ftp и smb добрался до чтения произвольных файлов. Браузер для веб-задач тоже не обязателен, есть headless-варианты, которые подключаются к агенту.
Отдельная тема это аутентификация. Короткоживущие access-токены, которые часто ротируются, даются моделям тяжело. Выручает подключение через MCP к прокси: агент берёт историю запросов, вытаскивает куки и данные авторизации и сам пробует работать с ними, например искать IDOR.
У всего этого есть граница в виде контекста, который для агента работает как память. Он не бесконечен. У больших моделей это около миллиона токенов, но качество заметно падает уже ближе к верхней части окна, а по подписке доступного контекста ещё меньше, и на остатке агент начинает сам себя суммаризировать. За моделью при этом нужно следить, потому что она любит срезать углы.
Читерить агент обожает. Любая модель всеми возможными способами пытается выполнить твою задачу, и это критичный момент, если не хочешь, чтобы она накосячила.
Сергей ЗыбневMCP, скиллы и локальные LLM для кибербезопасности
MCP (Model Context Protocol) и скиллы часто путают. MCP это тот же API, завёрнутый в удобный для агента формат, с обращением на естественном языке. Скилл же прямо задаёт примеры команд и подходов. Раньше тяжёлые надстройки с кучей ролей и инструментов были нужны, потому что модели плохо понимали специфику задач. После нескольких крупных обновлений моделей такая обвязка чаще мешает: проще дать компактные скиллы, чем раздувать контекст не токен-эффективной надстройкой вроде HexStrike. Из полезных MCP есть Context7, который держит векторизированную документацию и отдаёт её агенту; подсовывать туда непроверенные источники не стоит.
На боевых проектах этично использовать только локальные модели, чтобы запросы заказчика с URL, куками и полезной нагрузкой не уходили стороннему провайдеру.
Это вопрос приватности, и облачные модели для этого не годятся. Локальный запуск LLM упирается в железо. На одной игровой видеокарте с 32 гигабайтами памяти помещается модель примерно на 30 миллиардов параметров, и это нижняя планка для задач кибербезопасности. Контекст меньше 200 тысяч токенов для серьёзной работы брать не стоит. По скорости десктопная видеокарта сильно опережает ноутбук или Mac: там, где видеокарта выдаёт около 170 токенов в секунду, у Mac выходит ближе к 50, хотя память у Apple быстрая. Из открытых моделей под эти задачи называют Qwen, который хорош в коде и пентесте, а также GLM, Kimi K2 и MiniMax. DeepSeek слаб по части цензуры, и это делает его удобным, когда нужно тестировать защиту самих моделей.
Мифы про нейросети в пентесте
Вокруг нейросетей в пентесте собралось несколько устойчивых заблуждений, которые полезно развеять.
- галлюцинации никуда не денутся, это природа модели, а не временный дефект;
- к результату нельзя относиться с доверием по умолчанию, валидация руками обязательна;
- пайплайн ломается, как любая автоматизация, поэтому логи и результаты стоит фиксировать, чтобы повторить успех;
- есть риск бана со стороны провайдера: для модели нет разницы между авторизованным и неавторизованным взломом, и за это аккаунты блокируют;
- бенчмаркам нельзя верить слепо, место в рейтинге можно купить.
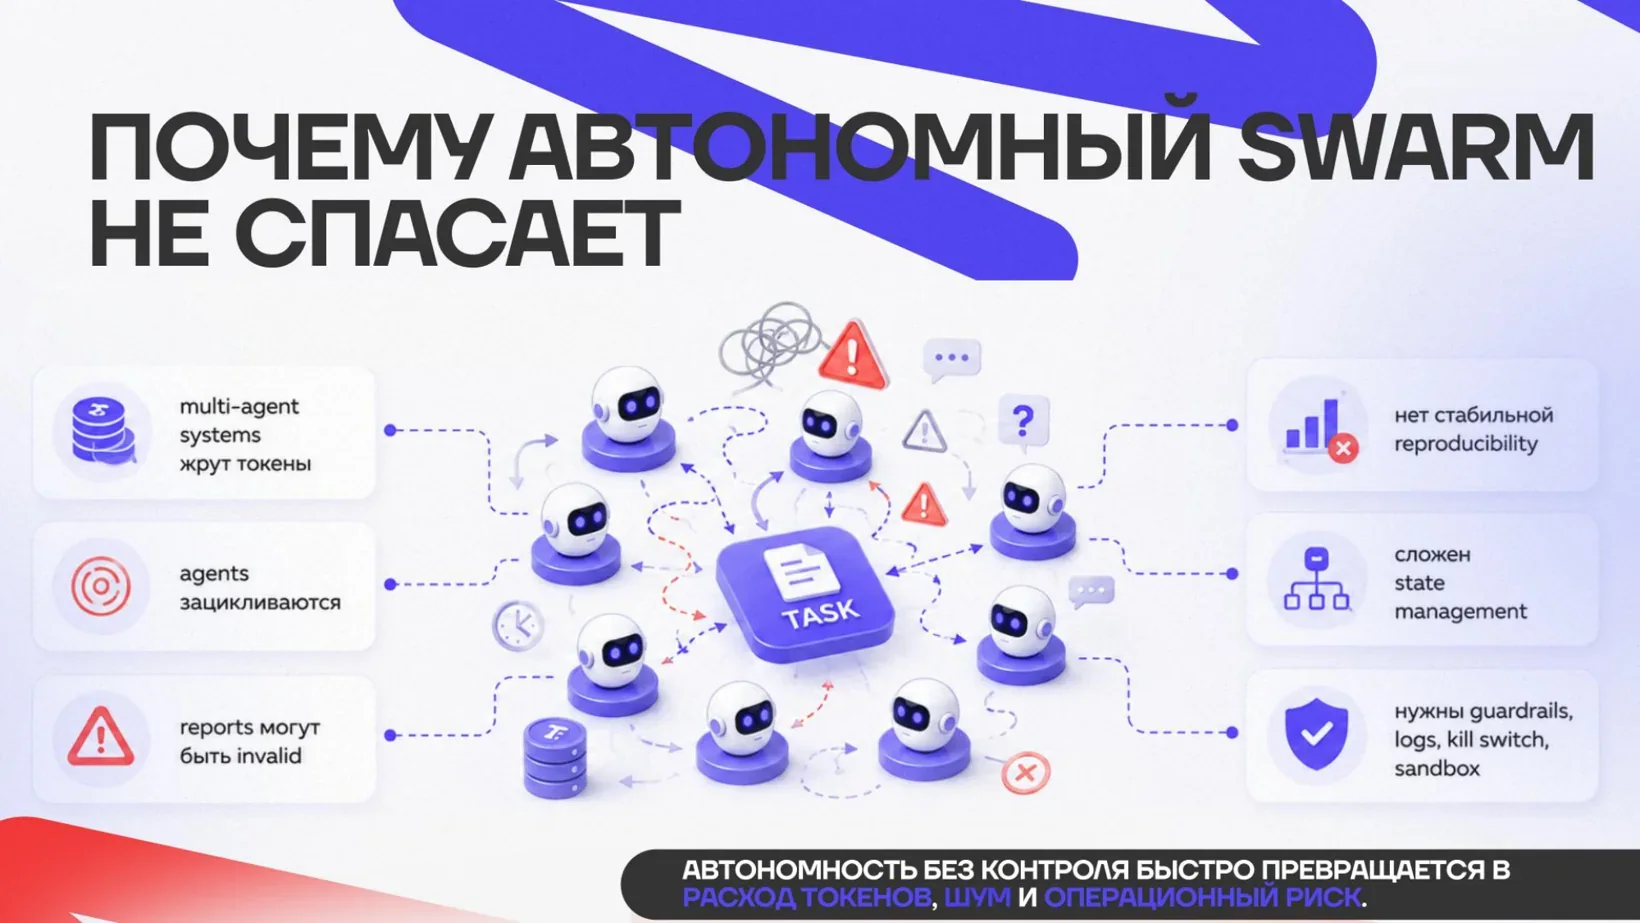
Отдельный миф это мультиагентные системы как универсальное решение. Для небольшой задачи это как запускать тяжёлую оркестрацию ради маленького сервиса: дорого, шумно, съедает токены и добавляет неопределённости, когда один агент передаёт другому не то и оба начинают делать чужую работу. Куда важнее воспроизводимость, чтобы успех на задаче повторялся из раза в раз, а не держался на удаче одного запуска.
Ещё эфиры по теме
 Тема:AI и агентыПентест455 участников1,2 млн долларов заработал хакер с AI-инструментами. Что в пентесте остаётся за человеком и какие роли изменятся первыми?
 Тема:AI и агентыПентест2842 участниковДва часа AI-агент сам проходит стенд, от переполнения стека до root. В ложные находки не лезет: сначала читает исходники, потом сканирует. А агенты участников застревали. Итог: 33 полных решения из 310 запусков.
 Тема:AI и агентыПентест2842 участниковОдна модель, два исследователя, разный результат. Разницу делает файл контекста для агента.