
AI-челлендж: воркшоп по сборке пентест-агента
Заполни форму, и видео запустится здесь же.
Готово. Видео появится здесь, как только загрузим его.
Нажимая кнопку, соглашаешься с обработкой персональных данных
О чём эфир
Для тех, кто хочет собрать своего пентест-агента и выйти с ним на AI-челлендж. Начнёшь с доступа к моделям: подписка, агрегатор или локальный запуск, и сколько видеопамяти под это нужно.
Поймёшь, почему у двух исследователей с одной моделью выходит разный результат. Причина в файле контекста: scope, ограничения, тестовые аккаунты и гипотезы. Отдельно про промпты без общих фраз.
На примере видно, как скилл каждые три минуты проходит по истории прокси в Burp и сам создаёт Repeater-запросы, а второй скилл управляет браузером. В конце сравнение моделей и инструментов и пошаговое подключение к челленджу на Standoff 365.

Забери материалы эфира
Презентацию и скиллы одним файлом: вернись к ним, когда будешь повторять на практике.
Скачать материалыРазбор эфира по темам
LLM в пентесте: где нейросети экономят часы
Языковые модели (LLM) в пентесте и багбаунти сильнее всего помогают там, где раньше уходила рутина. Самые очевидные задачи связаны с кодом:
- сгенерировать скрипт на Bash или Python;
- быстро собрать PoC под уязвимость;
- автоматизировать запросы к API;
- распарсить вывод инструментов.
То, что раньше писалось руками и долго отлаживалось, теперь собирается в несколько заходов.
Отдельно хорошо заходит анализ JavaScript. Файлы фронтенда нередко весят десятки, а то и сотни мегабайт, их приходится распаковывать и разбирать. Модель находит в них источники и приёмники пользовательских данных, показывает, откуда данные приходят и куда попадают, и заодно проверяет, есть ли валидация и санитизация.
Сюда же анализ логов. Это работает, но с оговоркой: лог утилиты на десяток килобайт модель осилит, а поток сработок и детекций из SIEM может просто не влезть в контекстное окно. Если скормить такой объём без настройки, результат будет слабым. Логи стоит разбирать так же вдумчиво, с подготовленной конфигурацией.
Есть и задачи ближе к реверсу: диф декомпилированного Java-кода в Android-приложениях, разбор ассемблерного кода. С дифами декомпилированной Java нормально справляются открытые модели GLM, и с ассемблером у современных моделей концептуальных проблем быть не должно.
Локальная LLM или подписка: сколько нужно видеопамяти
Способов получить доступ к LLM три:
- подписка напрямую у провайдера (OpenAI, Anthropic, DeepSeek) по API;
- агрегаторы вроде OpenRouter с оплатой по факту использования или Ollama с доступом к набору открытых моделей;
- локальный запуск открытой модели через бэкенд (vLLM, llama.cpp): скачиваешь веса, загружаешь бэкенд, получаешь ответы у себя.
Под локальный запуск LLM есть простое правило прикидки: берёшь число миллиардов параметров модели и умножаешь на два, получаешь примерный объём видеопамяти в гигабайтах. На контекст нужна дополнительная память сверху. Модные сейчас модели вроде Qwen и Gemma держатся около тридцати миллиардов параметров: под них комфортно иметь примерно шестьдесят четыре гигабайта памяти, например MacBook на ARM-процессоре с памятью такого объёма. Тяжёлые модели вроде GLM бывают на сотни миллиардов параметров, самая крупная просит около полутора терабайт, для неё есть версия полегче.
Бывает, что арендовать доступ у провайдера выходит дешевле, чем хостить модель у себя. Подписки начинаются примерно от двадцати долларов в месяц, с сессионными лимитами, которые сбрасываются каждые несколько часов, и недельным лимитом. Для плотной работы по скоупу одного сессионного лимита хватает где-то на час-полтора.
Промпт для поиска уязвимостей: почему «найди всё» не работает
Результат модели сегодня зависит не столько от её ума, сколько от того, как её настроили. Промпт в духе «найди все уязвимости и не делай ошибок» почти всегда даёт галлюцинации, ложные срабатывания и бессмысленный текст. Причина простая: модель не знает бизнес-логику приложения, которое ты исследуешь.
Ваше преимущество не в модели, а в том, как вы её настроили и какую задачу поставили агенту. Одна и та же модель у двух исследователей даёт радикально разный результат.
Багхантер KekisПромпт лучше строить иначе. Вместо «найди уязвимости» проси список из десяти приоритетных точек для проверки, отсортированный по вероятности эксплуатации, с указанием типа уязвимости и причины, по которой стоит проверить каждый эндпоинт.
Когда у модели есть роль, контекст и заданный формат ответа, она работает заметно лучше.
И к находкам стоит относиться скептически: модель любит кричать про критическую уязвимость на каждое сообщение.
На каждое «найдена критическая уязвимость» реагируй скептически: спроси, как подтвердить находку вручную, попроси минимальный PoC. После таких вопросов отваливается процентов девяносто пять находок.
Багхантер KekisОставшиеся находки полезно перепроверить два-три раза, желательно разными моделями. Часть подтвердится, часть отсеется повторными проверками.
Файл контекста для AI-агента: скоуп, правила, тестовые аккаунты
Первый инструмент настройки AI-агента: файл контекста, память проекта, к которой модель обращается по мере работы. В него складывают скоуп, что в скоупе и вне его, ограничения программы, технический стек, тестовые аккаунты и полезные наблюдения. Например: этот эндпоинт отдаёт 502, здесь интересный параметр, тут не докрутил SQL-инъекцию.
С файлом контекста можно вернуться к программе спустя время и не начинать всё с нуля.
Отдельно стоит вынести код поведения и ограничения, которые задаёт площадка или программа: не класть сервис, не делать деструктивных действий, работать доменами по несколько штук за раз. На платформах вроде Standoff 365 правила программы и запреты обычно описаны отдельными пунктами, их достаточно скопировать в свои файлы. Приоритетные и внескоповые типы уязвимостей тоже лучше прописать: тогда модель, найдя что-то, сразу понимает, примут это или нет.
Методология пентеста в модульных файлах и цикл охоты
Удобная схема: вся методология пентеста лежит в отдельных модульных файлах. Предварительные условия о программе, скоуп, код поведения, приоритетные уязвимости, набор проверенных пейлодов. Пейлоды пригодятся, когда собственные попытки модели не сработали: ей говорят, что в такой-то папке лежат пейлоды по типам уязвимостей, пусть берёт оттуда.
Два файла отвечают за память. Progress хранит прогресс, чтобы с чистого контекста продолжить с того места, где остановился, и не потерять нить. Decisions логирует решения, которые принимала модель. По нему потом удобно искать не только ложные срабатывания, но и ложно отвергнутые гипотезы: когда модель нашла что-то рабочее, но почему-то отбросила.
Сверху кладётся методология охоты: цикл, который не даёт агенту остановиться на полпути. В такой схеме агент идёт по кругу:
- 1
Берёт по три цели в батч.
- 2
Ищет на них уязвимости.
- 3
Верифицирует находки по методологии и делает отметки.
- 4
Переходит к следующему батчу, учитывая, что нашлось на предыдущих хостах.
Чтобы запустить всё это на новую цель, достаточно переписать несколько файлов со скоупом и поменять название проекта.
Скиллы агента и MCP-сервер для Burp и Caido
Скилл это твоя методология, ужатая в формат, понятный AI-агенту. Лежит папкой с файлом в директории скиллов. В начале файла есть имя и описание, и описание важно делать коротким и ёмким: именно оно работает триггером, по которому агент сам понимает, когда вызвать скилл.
MCP-сервер это мостик между моделью и твоими инструментами: прокси, сканерами, утилитами. Для Burp или Caido такой сервер даёт модели напрямую читать запросы, которые идут через прокси, повторять их и анализировать результаты.
Через MCP-сервер ты отдаёшь модели руль, а сам контролируешь результат.
Скиллы при этом могут вызывать другие скиллы и выстраиваться в цепочку: один собирает данные, другой идёт с ними в нужную программу.
Автоматизация пентеста: агент сам следит за историей прокси
Связка из двух скиллов работает так. Один делает фингерпринт приложения: разбирает историю запросов в прокси Caido и строит поверхность атаки, чтобы не просматривать каждый запрос вручную. У него есть режим мониторинга: фоновая задача каждые три минуты смотрит историю, ищет признаки уязвимостей, перепроверяет их и, если признак похож на настоящий, создаёт Replay-таб с хостом и находкой.
Второй скилл, интерсептор, управляет браузером напрямую из агента через расширение. Модель открывает страницы, нажимает кнопки, заполняет формы. Это выручает на приложениях со сложной аутентификацией, которую агенту пройти непросто: заходишь в браузере сам, а дальше модель строит уже аутентифицированную поверхность атаки.
Вместе это комбайн. Интерсептор водит агента по приложению, трафик летит в прокси, скилл фингерпринта забирает историю и создаёт Replay-табы с интересными находками, которые потом разбираешь уже экспертно. Проверять результат одного скилла другим можно почти бесконечно, это отдельная большая история.
Как участвовать в AI-челлендже на Standoff 365
Порядок подключения к AI-челленджу по пентесту простой.
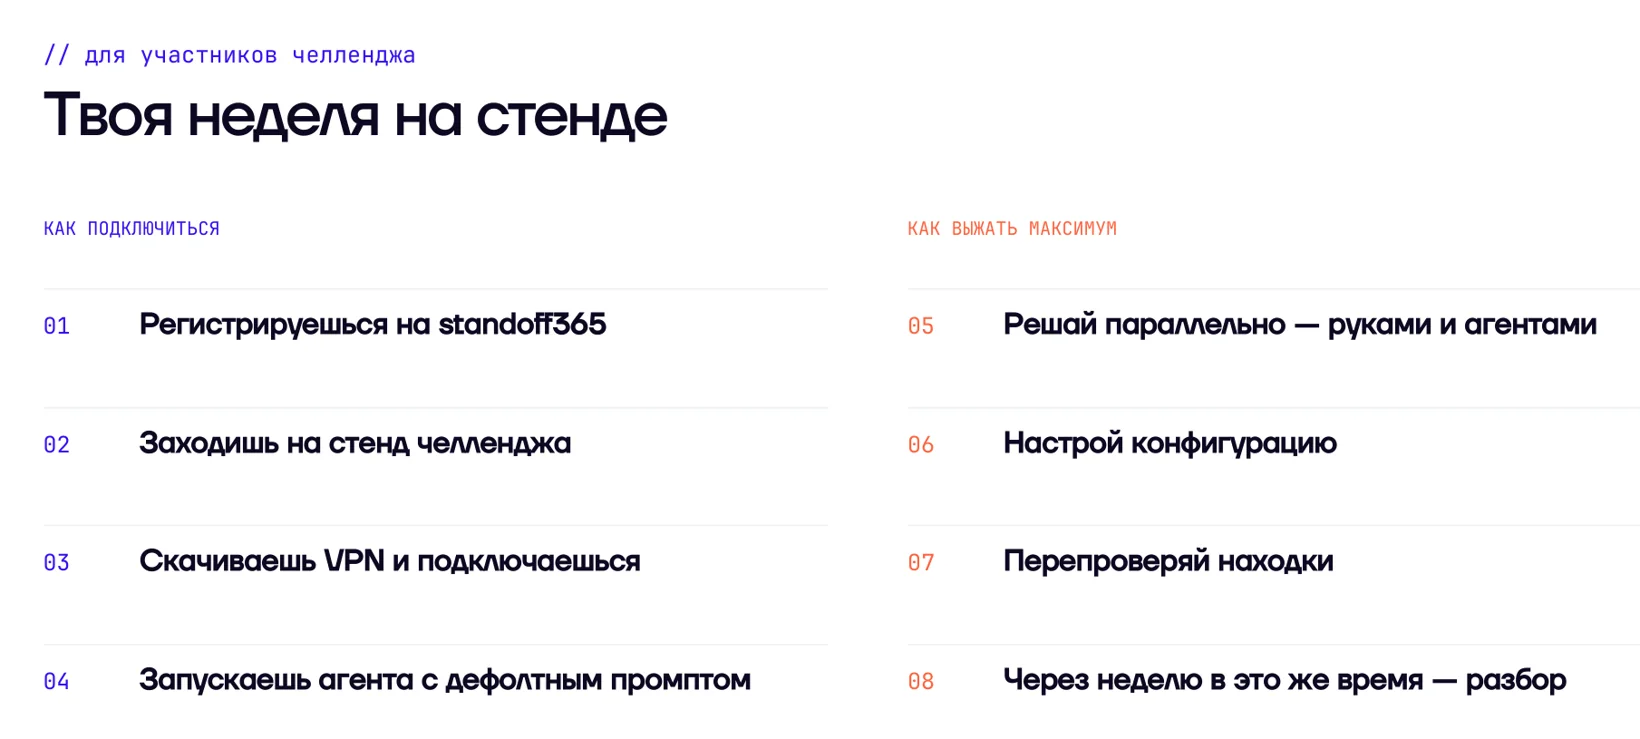
Стенд челленджа лежит на Standoff Hackbase, а в готовый промпт перед запуском подставляешь имя своего аккаунта на Standoff 365.
Файл с инструкциями стенда описывает, где находится стенд, какие уязвимости искать и как сдавать флаги, и его можно дополнить своим контекстом и пейлодами. Инфраструктура авторесетится каждые девяносто минут: если что-то упало, достаточно перезапустить агента, а сам стенд ломать не нужно.
Главное: делать задание и руками, и с агентом, и честно сравнивать, где модель буксовала, где ты оказался сильнее, где она обгоняла по скорости.
Смысл не в том, чтобы прогнать стенд на автомате, а в том, чтобы увидеть узкие места, которые вылезают при работе с моделями в пентесте и багбаунти. И держать себя в контексте: следить за новыми моделями, подходами, инструментами, потому что индустрия меняется каждую неделю.
Модель это мультипликатор ваших навыков, а не замена им. Сначала нужно учиться самому, качать знания, и только потом делегировать модели рутину внутри своей методологии.
Багхантер KekisЕщё эфиры по теме
 Тема:AI и агентыПентест455 участников1,2 млн долларов заработал хакер с AI-инструментами. Что в пентесте остаётся за человеком и какие роли изменятся первыми?
 Тема:AI и агентыПентест2842 участниковДва часа AI-агент сам проходит стенд, от переполнения стека до root. В ложные находки не лезет: сначала читает исходники, потом сканирует. А агенты участников застревали. Итог: 33 полных решения из 310 запусков.
 Тема:AI и агентыПентест522 участниковЧеловек против AI-агента: две задачи, каждая решена дважды. Агент быстрее, но не всегда самым коротким путём. Плюс как его ограничить.