5 шагов, чтобы собрать AI-агента для пентеста
Окружение и модели, инструменты через MCP, контекст и навыки, роли с верификаторами и правила, которые держат агента в скоупе. С цифрами и примерами из эфиров CyberED.

Что AI-агент для пентеста уже делает сам
Быстрее всего агентов взяли в работу пентестерские компании, которые разрешают специалистам открыто пользоваться моделями, и багбаунти. Там агент закрывает почти полный цикл: разведку, триаж находок, распознавание паттернов. Во внутреннем анализе защищённости, где компании проверяют собственные продукты, агенты только появляются: мощные внешние модели во внутреннюю инфраструктуру не пускают.
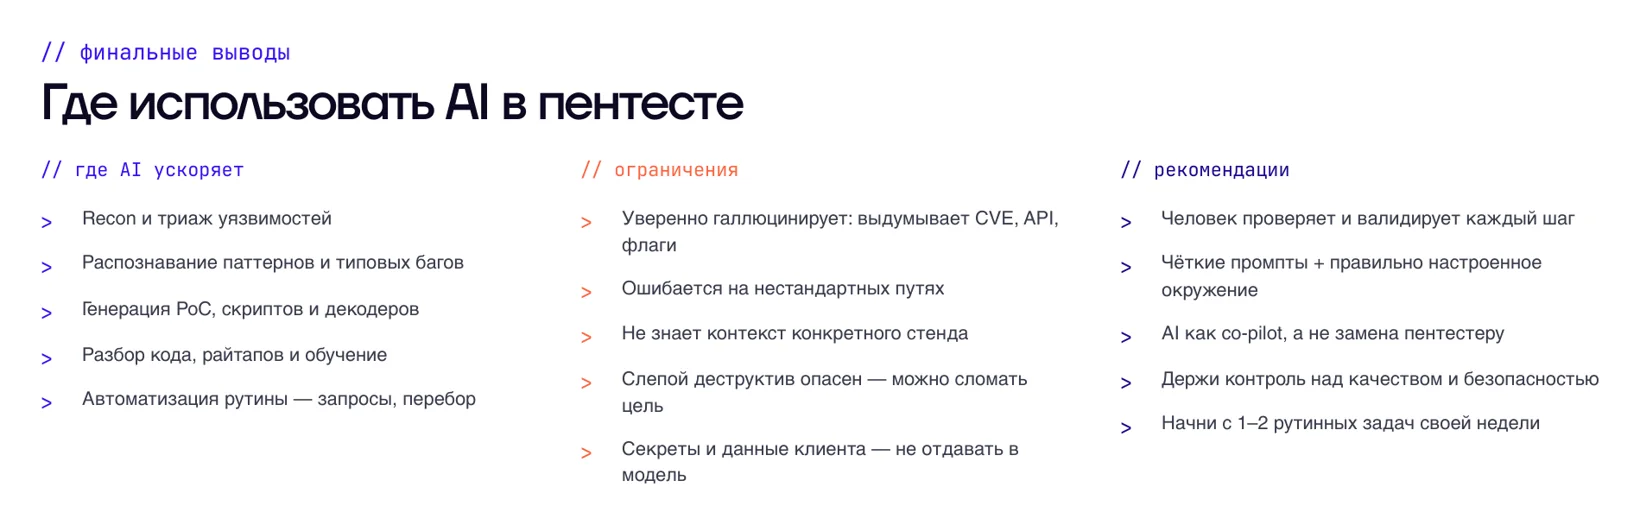
Что агент берёт на себя уже сейчас:
- активное и пассивное сканирование через командную строку;
- скрипты на Bash и Python и быстрый PoC под уязвимость;
- скриншоты для отчёта;
- разбор JavaScript фронтенда, который весит десятки и сотни мегабайт: где данные приходят от пользователя, куда попадают и есть ли валидация;
- регистрацию тестовых аккаунтов через браузер с чтением кодов подтверждения из почты по API, чтобы проверить IDOR.
Шаг 1. Окружение и модели
Базовая схема: вся работа идёт на виртуальной машине с Kali Linux, а через универсальный шлюз агент ходит к разным языковым моделям. Модель меняется под задачу. На разведку ставят лёгкую и быструю: токенов уходит меньше, а сложного там ничего нет.
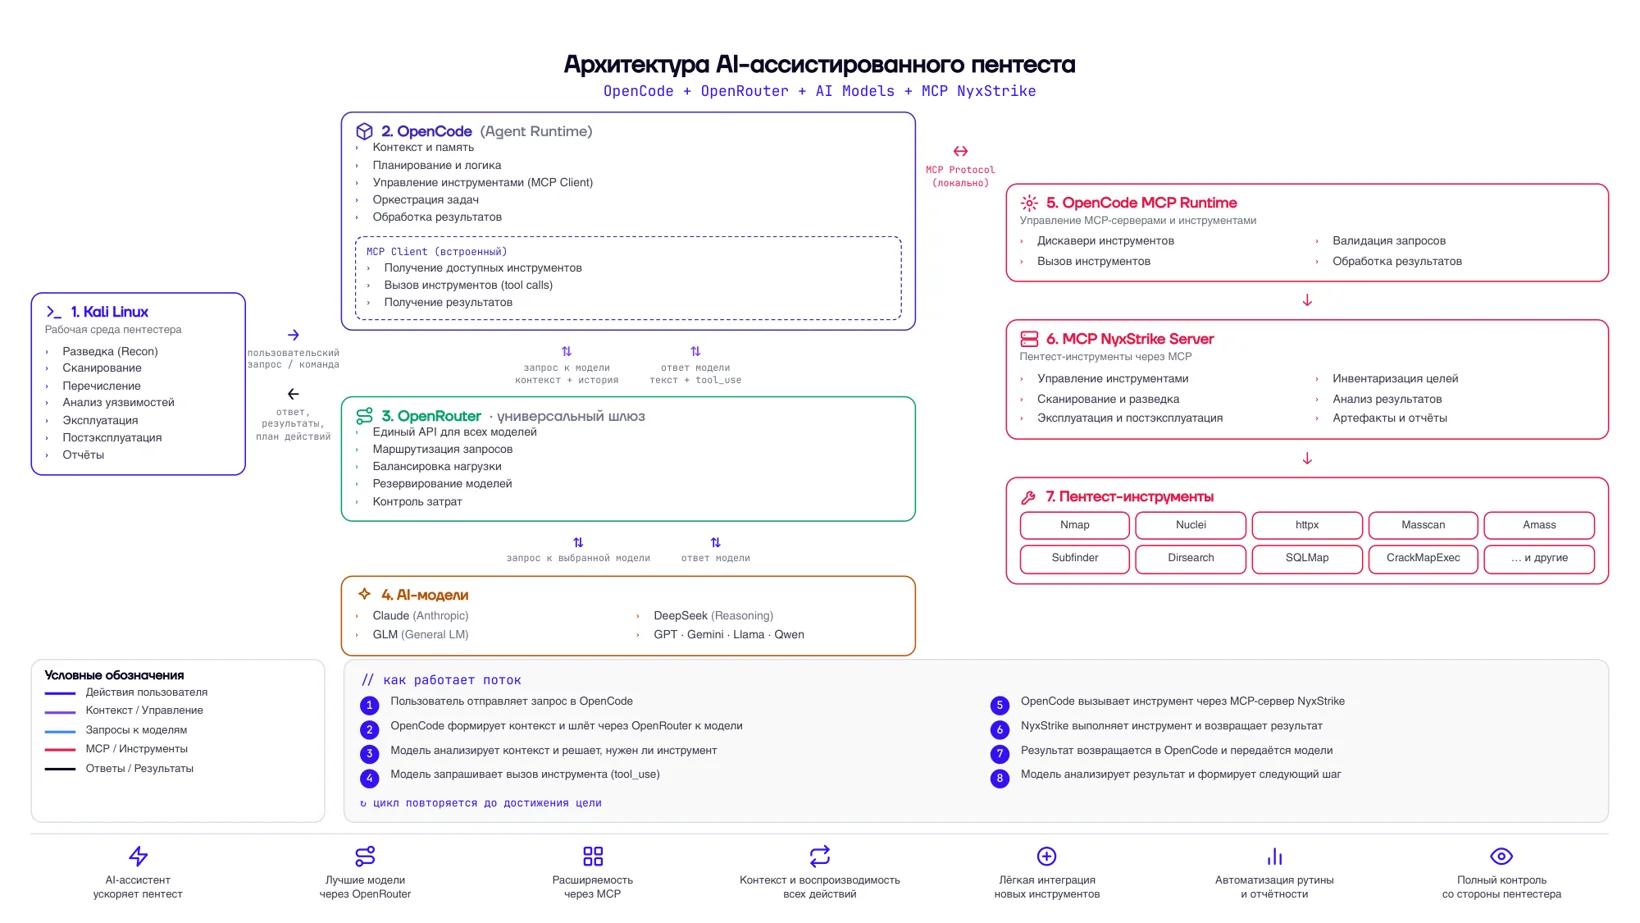
Доступ к модели получают тремя способами:
- подписка у провайдера по API: от 20 долларов в месяц, сессионного лимита при плотной работе по скоупу хватает на час-полтора;
- агрегаторы вроде OpenRouter с оплатой по факту или Ollama с набором открытых моделей;
- локальный запуск через vLLM или llama.cpp.
Для локального запуска есть прикидка: миллиарды параметров модели умножить на два, получишь гигабайты видеопамяти, плюс запас на контекст. Модель на 30 миллиардов параметров помещается на игровую видеокарту с 32 ГБ памяти, и это нижняя планка для задач безопасности. Контекст меньше 200 тысяч токенов для серьёзной работы не берут. Видеокарта выдаёт около 170 токенов в секунду, Mac ближе к 50.
На проектах заказчика этично работать только локальной моделью: запросы с URL, куками и полезной нагрузкой не должны уходить стороннему провайдеру.
Шаг 2. Инструменты через MCP
MCP-сервер (Model Context Protocol) это мост между моделью и твоими инструментами: прокси, сканерами, утилитами. По сути тот же API, завёрнутый в формат, понятный агенту.
Что даёт MCP к прокси:
- в Burp Suite агент читает HTTP history, складывает запросы с полезными нагрузками в Repeater и дописывает туда свои находки;
- в Caido фоновая задача каждые три минуты разбирает историю запросов, ищет признаки уязвимостей и на похожие на настоящие создаёт Replay-таб;
- при сложной аутентификации ты логинишься в браузере сам, а агент берёт из истории прокси куки и токены и работает уже под пользователем.
Посмотри, как агент пользуется окружением, например настроены ли API у утилит, которые он запускает. Часто он сам подсветит, чего не хватает.
Шаг 3. Контекст проекта и навыки
Первое, что настраивают, это файл контекста: память проекта, к которой агент обращается по ходу работы. В нём скоуп и что вне скоупа, правила программы, стек, тестовые аккаунты и наблюдения вроде «этот эндпоинт отдаёт 502». С таким файлом к программе можно вернуться спустя время и не начинать с нуля.
Ещё два файла держат память между сессиями: progress хранит, где остановились, decisions логирует решения модели. По второму потом ищут не только ложные срабатывания, но и гипотезы, которые агент отбросил зря.
Навык (скилл) это продвинутый промпт: цель, этапы, конкретные инструкции. Лежит папкой с файлом, а короткое описание в начале работает триггером, по которому агент сам понимает, когда навык вызвать. Библиотеку навыков удобно собирать вместе с агентом:
- 1
Поручить агенту пройти по раскрытым отчётам багбаунти и собрать навык на каждый класс уязвимостей.
- 2
Посмотреть, чего не хватает.
- 3
Попросить агента изучить недостающие темы и добавить навыки.
Большой навык описывает всю методологию: как безопасно обнаружить проблему, какие нагрузки брать, что делать, когда стандартный путь закрыт. Сначала агент определяет стек цели и пробует уязвимости, характерные для него. Тяжёлые готовые надстройки с кучей ролей и инструментов после последних обновлений моделей чаще мешают: компактные навыки съедают меньше контекста.
Шаг 4. Роли и проверка находок
В сложной системе агент работает как команда:
- оркестратор управляет всем и живёт отдельным субагентом, чтобы с ним можно было переписываться по ходу работы;
- декомпозер разбивает цель на задачи и решает, что простое, а что сложное;
- исполнитель и критик делают работу и проверяют ход решения;
- верификатор подтверждает находку.
Работа идёт от цели, например найти одну критическую уязвимость. Оркестратор не останавливается, пока верификатор её не подтвердит. Чтобы отсеять ложные срабатывания, на одну уязвимость ставят трёх верификаторов, и проверка идёт, пока они не сойдутся.
Даже если настроишь верификатор, это не гарант того, что уязвимость действительно есть. Руками всё равно придётся работать.
Никита КоломиецХороший фильтр для любой «критической» находки: спросить модель, как подтвердить её вручную, и попросить минимальный PoC. После таких вопросов отваливается около 95% находок. Остальное перепроверяют два-три раза, лучше разными моделями.
Шаг 5. Рамки: скоуп, правила и хуки
Ответственность за действия агента несёт человек, который его запустил: закона, который снимал бы её с оператора, нет ни в России, ни в мире. Поэтому главный принцип один: человек проверяет каждый шаг. Если устал, проверяй хотя бы находки и держи включённым scope checker, который сверяет каждый IP и домен со скоупом.
Правила безопасной эксплуатации лучше прописать агенту явно:
- при XSS писать в консоль, а не вызывать окно на всю страницу;
- получив доступ к базе, взять несколько строк для подтверждения и не вычитывать её;
- найдя SSRF, не лезть вглубь, а сообщить и спросить следующий шаг;
- аккаунты не удалять.
Хуки в консольных агентах механически блокируют опасное действие до выполнения: запрет rm -rf с любыми путями, защиту от атак встроенными утилитами системы (LOLBin), запуск только через нужный пакетный менеджер. Правила самой программы багбаунти агент читает по ссылке.
Где агент ошибается
- Находит уязвимости, которых нет. Отрицательные рейтинги на багбаунти чаще всего у тех, кто дал агенту сессию и отпустил его слать отчёты подряд.
- Работает нестабильно. В десяти запусках находит уязвимость, а в одиннадцатом нет.
- Не знает контекст. Данные могут лежать в открытом доступе по задумке сервиса, и без подсказки агент запишет это в уязвимости. На нестандартные векторы его направляют: видишь разбор XML, подскажи проверить XXE.
- Срезает углы. Модель всеми способами пытается выполнить задачу, в том числе нечестно.
- Теряет качество к концу контекста. У больших моделей окно около миллиона токенов, но ближе к верхней границе ответы заметно хуже, а агент начинает сам себя пересказывать.
- Упирается в классификаторы. Сильные модели блокируют офензивные задачи, а за взлом без разрешения провайдеры банят аккаунты. Для багбаунти у провайдера проходят верификацию специалиста по безопасности.
Человек против агента: проверка на CTF
Три простые CTF-задачи решали дважды: сначала руками, потом агентом. Агенту каждый раз давали только описание задачи и ссылку.
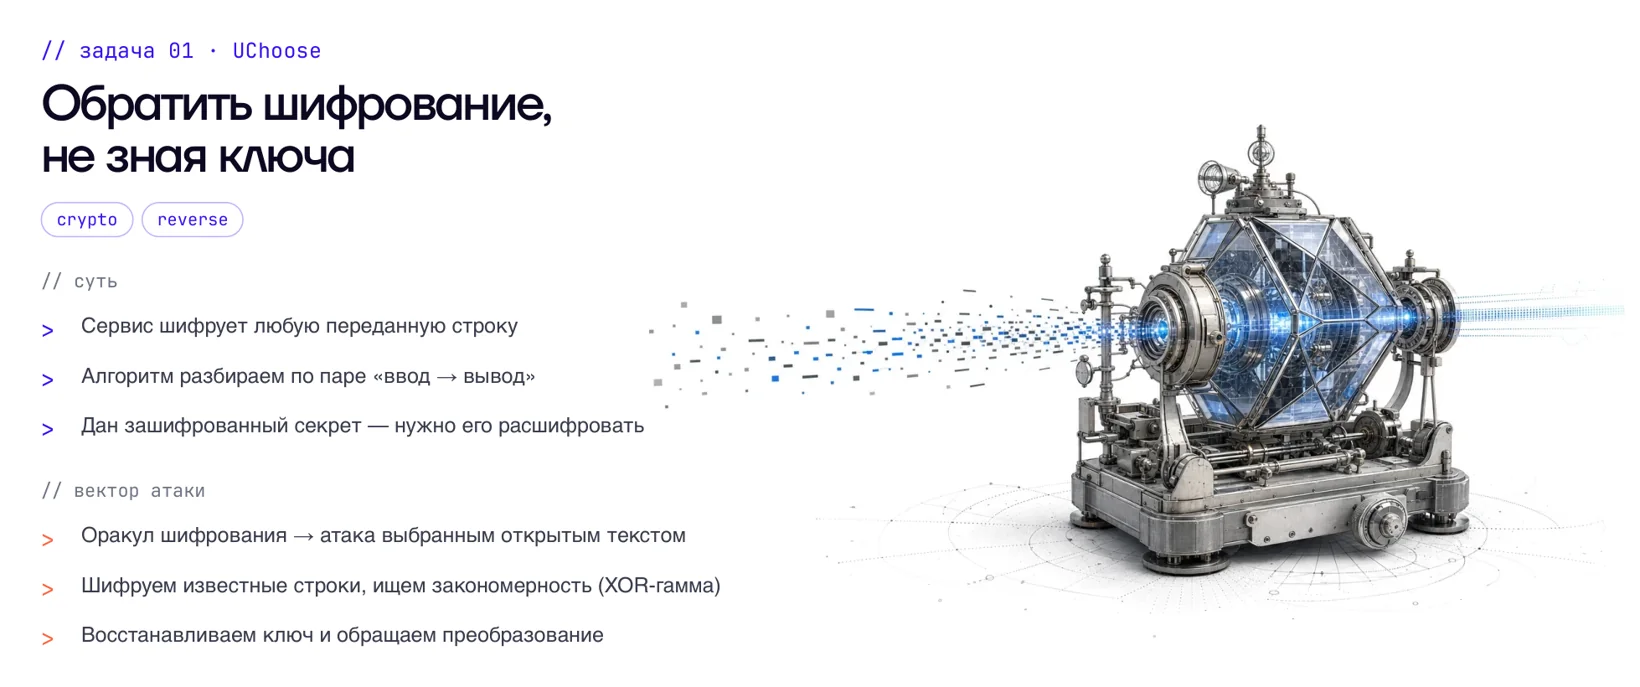
В первой задаче сервис шифровал строку через XOR и отдавал её в Base64. Руками путь такой:
- 1
Ввести длинную строку из одной буквы и получить ответ в Base64.
- 2
Декодировать Base64 и получить строку после XOR.
- 3
По известному открытому тексту восстановить ключ XOR.
- 4
Расшифровать флаг этим ключом и ещё раз декодировать Base64.
- 5
Развернуть строку: флаг лежал задом наперёд.
Агент сам прошёл по сервису, нашёл ключ и выдал флаг с кратким отчётом.
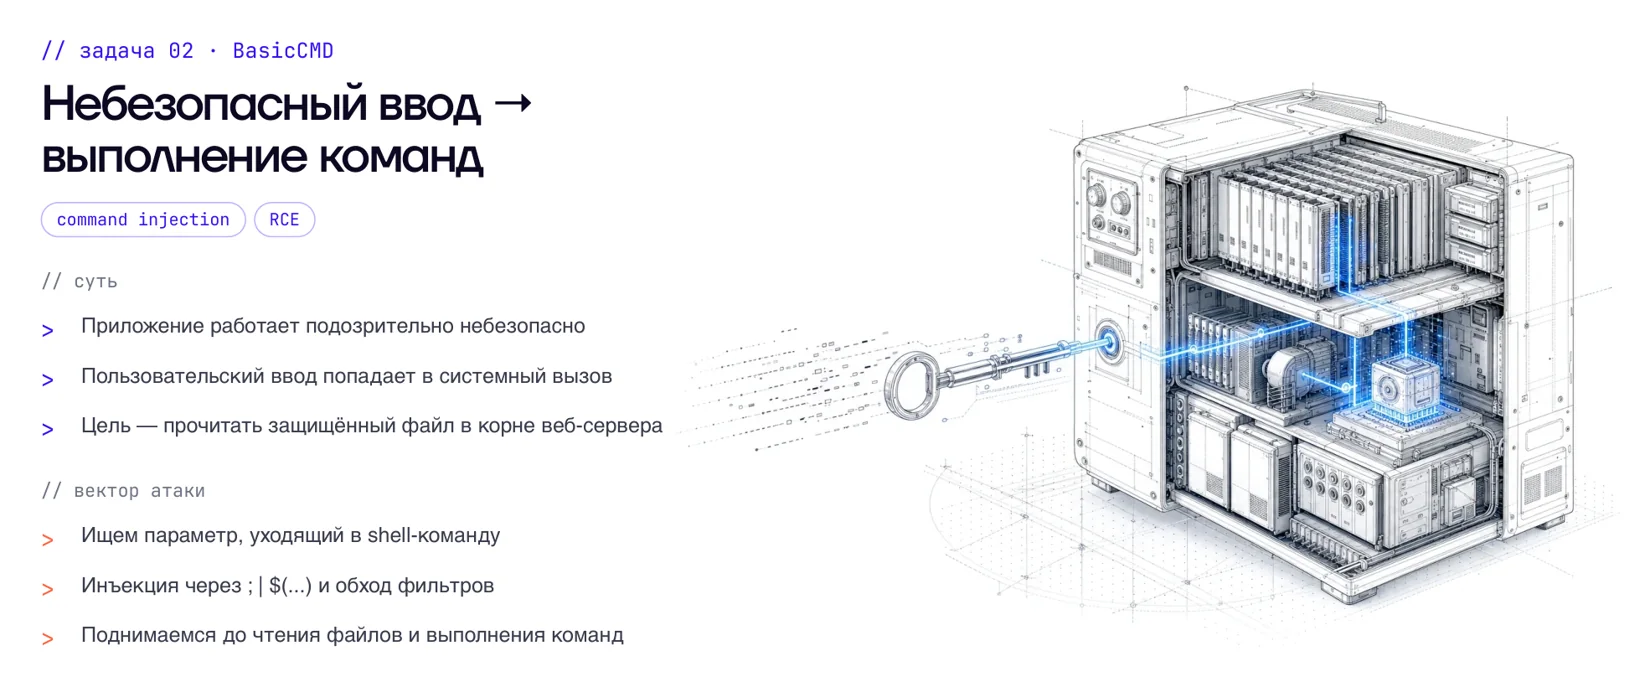
Во второй задаче пользовательский ввод попадал в системный вызов, а часть символов фильтровалась. Агент распознал формат ответа, нашёл обход фильтра и прочитал флаг. Человек справился чуть быстрее, но только потому, что заранее знал решение. Самым коротким путём не пошёл никто: флаг лежал в переменной окружения.
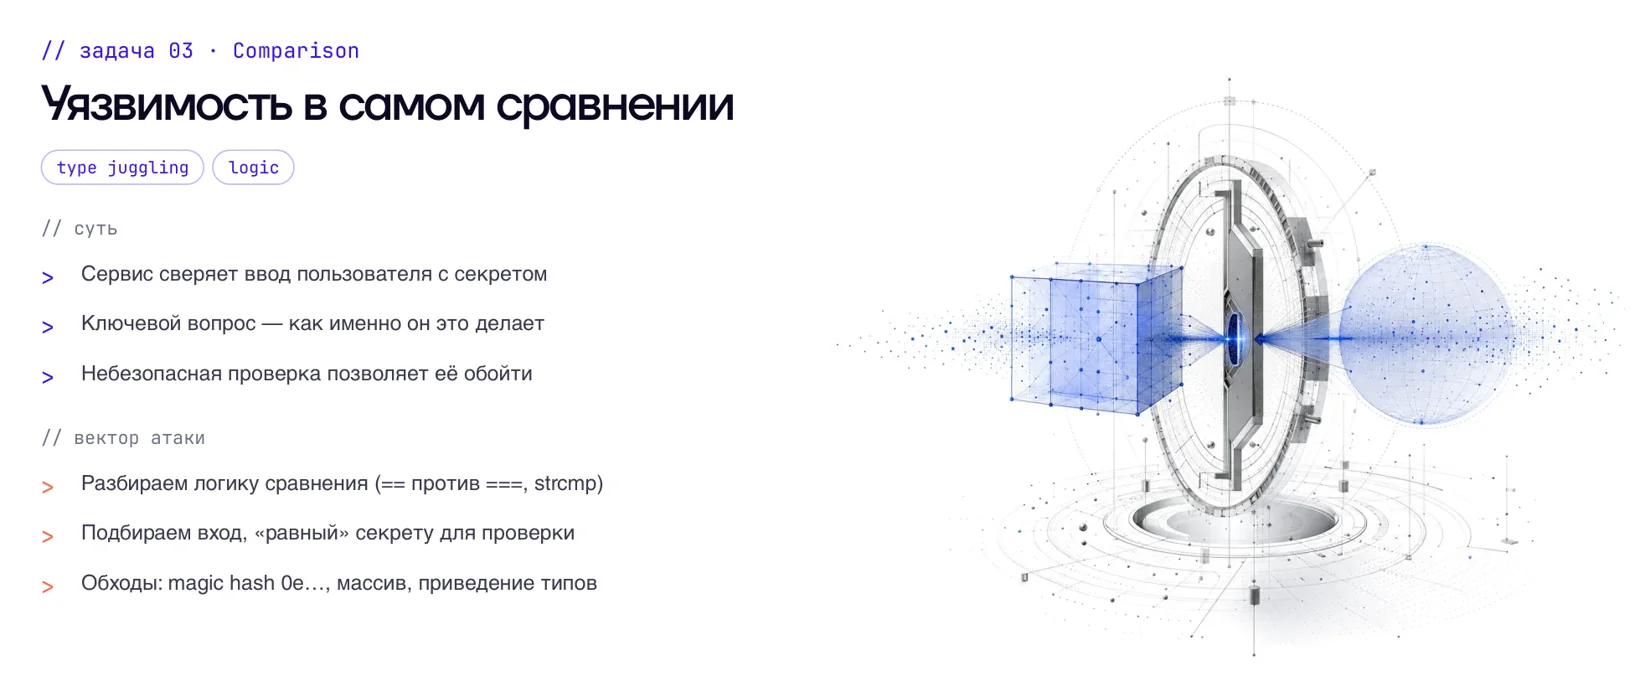
В третьей задаче сервис сверял ввод с зашифрованным флагом, и обойти нужно было саму проверку. Агент решил её примерно за минуту, человек примерно за две.
На воркшопе 3 ноября так же разбирали таски по вебу: SQL-инъекцию, XSS и SSTI. На небольших учебных задачах многоролевая система не нужна: агент с настройками по умолчанию сам понимает, что перед ним SQL-инъекция, и начинает её искать. Своя система с ролями и библиотекой навыков окупается на большом приложении.
Что нужно уметь, чтобы работать с агентом
Высшей математики не нужно. Если ты понимаешь пентест, ты уже работаешь в терминале и быстро разберёшься с консольным агентом. Агент остаётся вторым пилотом: рядом с ним нужен уверенный специалист уровня middle и триажер с опытом.
Это не значит, что мы посадим стажёра и сэкономим кучу денег. Всё ещё надо настраивать, донастраивать и смотреть ресёрч.
Никита КоломиецОтрасль активно развивается, и уже сейчас надо начинать делать какие-то свои исследования.
Никита КоломиецЧастые вопросы
Что нужно, чтобы собрать AI-агента для пентеста?
Виртуальная машина с Kali Linux, доступ к языковым моделям через шлюз, инструменты, подключённые через MCP-сервер, файл контекста проекта и библиотека навыков под классы уязвимостей. Каждую находку проверяет человек.
Какая видеокарта нужна для локальной модели?
Прикидка: миллиарды параметров умножить на два, получишь гигабайты видеопамяти, плюс запас на контекст. Модель на 30 миллиардов параметров помещается на видеокарту с 32 ГБ памяти.
Что такое MCP в пентесте?
MCP-сервер это мост между моделью и инструментами: прокси, сканерами, утилитами. Через него агент читает историю запросов в Burp Suite или Caido, повторяет их и анализирует ответы.
Можно ли доверять находкам AI-агента?
Нет. Агент находит уязвимости, которых нет, и работает нестабильно. Каждую находку подтверждают вручную, просят минимальный PoC и перепроверяют разными моделями.
Эфиры по теме
Все эфиры
 Тема:AI и агентыПентест522 участниковЧеловек против AI-агента: две задачи, каждая решена дважды. Агент быстрее, но не всегда самым коротким путём. Плюс как его ограничить.
 Тема:AI и агентыПентест2842 участниковОдна модель, два исследователя, разный результат. Разницу делает файл контекста для агента.
 Тема:AI и агентыПентест895 участниковОтчёты от AI пока слабые. Зато агенты экономят часы, хоть и выдумывают. Связка AI и своих скриптов надёжнее чистой модели. И где начинаются юридические риски.